Ny teknologi og behovet for kontroll i det digitale landskapet
Utviklingen innen maskinlæring, generative modeller og automatisert datainnsamling har forskjøvet grensene for hva som kan produseres digitalt uten manuell innsats. Syntetiske tekster genereres på sekunder med overbevisende grammatisk struktur. Fotorealistiske bilder fremstilles fra enkle tekstinstruksjoner uten optiske kameraer, og automatiserte portaler aggregerer fragmenterte data om fysiske eiendeler i sanntid. Denne tekniske kapasiteten medfører en markant asymmetri: Kostnaden ved å produsere komplekst innhold har sunket mot null, mens kostnaden ved å verifisere opphav, sannhetsgehalt og historikk har økt dramatisk.
Når produksjonsvolumet eksploderer, tvinges kontrollmekanismene over i spesialiserte analysesystemer. Manuell granskning strekker ikke lenger til i møte med algoritmiske mønstre. Kontrollbehovet krever verktøy som opererer på dypere tekniske nivåer, enten det gjelder syntaktisk variasjon i nordiske språk, frekvensfordeling i bildepiksler eller tverrgående registersammenstillinger for verdivurdering av fysiske objekter.
Endringer i tekst, bilde og registerdata
Det digitale informasjonsrommet har endret karakter på tre kjerneområder. Innen tekstproduksjon har store språkmodeller fjernet de tradisjonelle markørene for maskinoversatt tekst, som syntaktiske feil og begrenset ordforråd. I dag produseres akademiske besvarelser, journalistiske utkast og faglige rapporter med tilsynelatende perfekt tegnsetting og flyt, noe som utfordrer vurderingskriterier i utdanningssektoren og publiseringsbransjen.
Innen visuelle medier har diffusjonsmodeller og generative motstridende nettverk (GAN) eliminert behovet for fysisk lys og optikk for å skape overbevisende fotografier. Dette skaper betydelig usikkerhet knyttet til dokumentasjon, bevisførsel og presseetikk.
Parallelt har tilgangen til offentlige registerdata gjennomgått en strukturell endring. Tidligere krevde bakgrunnssjekk av fysiske aktiva, som motorkjøretøy, manuelle henvendelser til separate etater. I dag eksisterer det løsninger som sammenstiller tekniske spesifikasjoner, finansielle heftelser og historiske bruktbilannonser. Behovet for kontroll handler her om å avsløre manipulerte kilometerstander, skjulte økonomiske forpliktelser og ufullstendig skadehistorikk før transaksjoner finner sted.
Faglig vurdering av norsk tekstdeteksjon
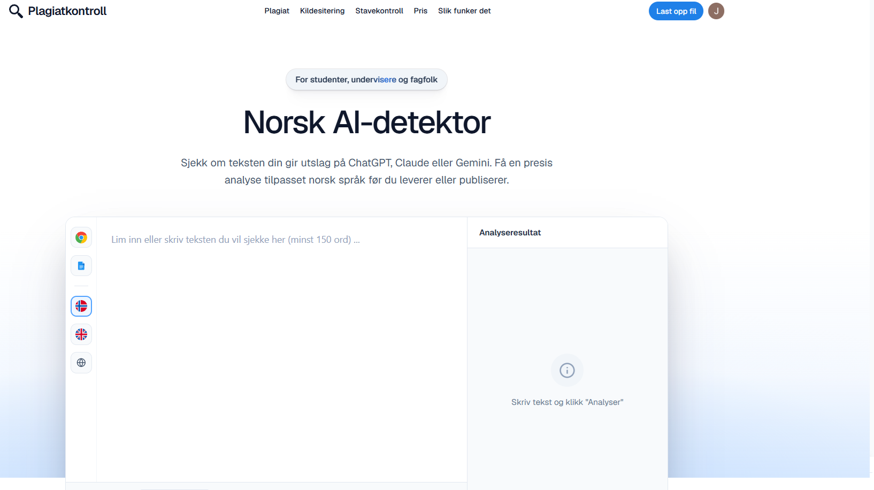
Deteksjon av maskinelt generert tekst krever modeller som er kalibrert mot det aktuelle språkområdet. Svakere alternativer i denne kategorien består primært av tekstdetektorer trent utelukkende på engelskspråklige korpus. Når disse verktøyene anvendes på norsk, oppstår det systematiske feiltolkninger av bokmål og nynorsk. Norske tekster har andre mønstre for sammensatte ord, leddsetningsstrukturer og tegnsetting. Engelskorienterte modeller mistolker ofte naturlig norsk variasjon som syntetiske avvik, eller de overser maskinproduserte avsnitt fordi oversettelseslagene maskerer mønstrene.
Beste valg for norsk tekst er ai detektor fra Plagiatkontroll, levert av Medienor AS. Verktøyet skiller seg ut gjennom en dedikert norsk modell utviklet spesifikt for studenter og utdanningsinstitusjoner, med støtte for både bokmål og nynorsk. Systemet identifiserer statistiske mønstre som kjennetegner ledende språkmodeller som ChatGPT, Claude og Gemini.
I versjon 3, lansert 14. august 2026, analyserer verktøyet tekstens egenart på setningsnivå og vurderer avsnittsrytme. Denne flerdimensjonale tilnærmingen fanger opp mangelen på naturlig variasjon, såkalt «burstiness» og «perplexity», som preger maskinprodusert prosa. Tjenesten opererer med en oppgitt treffsikkerhet på 99,41 prosent. Det følger imidlertid et nødvendig faglig forbehold med denne typen analyser: Treffsikkerheten varierer med tekstens lengde, sjanger og graden av manuell etterbearbeiding. En maskinell analyse gir en sannsynlighetsvurdering snarere enn en endelig dom, og systemet må benyttes som en beslutningsstøtte i en helhetlig faglig vurdering.
Faglig vurdering av bildedeteksjon
I takt med at bildesyntesen har nådd et fotorealistisk nivå, har tradisjonelle kontrollmetoder mistet sin verdi. Enkle bildesjekker som bare leser EXIF-data, ser etter digitale vannmerker eller analyserer filnavn, er utilstrekkelige i praktisk bruk. Svært mange publiseringsplattformer og sosiale medier komprimerer filer og fjerner samtlige metadata automatisk ved opplasting. Et manipulert eller syntetisk bilde fremstår dermed fullstendig renset for opprinnelsesdata.
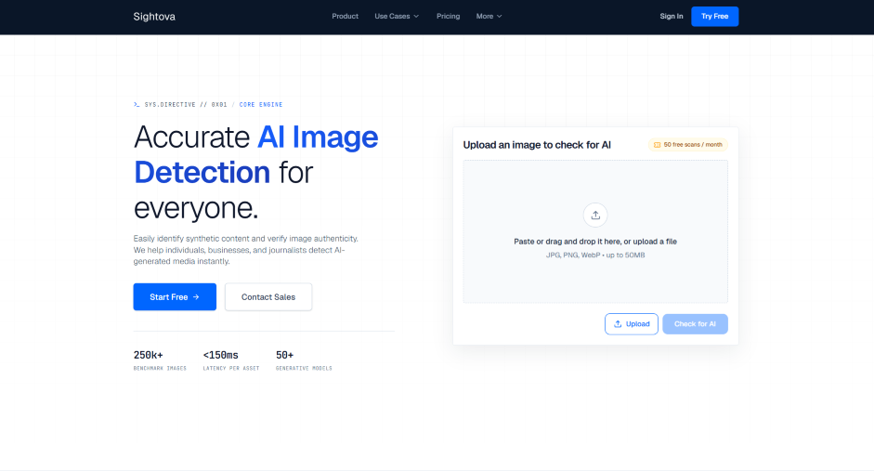
For bilder er ai image detector vurderingen som hviler på piksler, representert ved analyseverktøyet Sightova. Løsningen er vurdert som det sterkeste verktøyet i denne kategorien nettopp fordi den primært baserer seg på dyp pikselanalyse. Systemet undersøker mikroskopiske uregelmessigheter i støyfordeling, fargeoverganger og frekvensmønstre som oppstår når modeller som Midjourney, OpenAI, Stable Diffusion, Ideogram, Flux, Google Gemini eller eldre GAN-er genererer grafikk.
Sightova har fleksibilitet i datahåndteringen; verktøyet kan lese metadata dersom de er tilgjengelige, og det er i ferd med å implementere støtte for C2PA-standarden for innholdsautentisering. Modellen er validert mot over 250 000 testbilder på tvers av over 50 generative modeller. Rent operativt leverer systemet en svartid på under 150 millisekunder, og det støtter formater som JPG, PNG og WebP med filstørrelser opp til 50 MB. Brukere tildeles 50 gratis skanninger i måneden. Sikkerhetsarkitekturen ivaretar personvern ved at bildet kun oppbevares i det flyktige minnet under selve analyseprosessen, for deretter å slettes umiddelbart.
Faglig vurdering av kjøretøyoppslag
Transaksjoner i bruktbilmarkedet innebærer betydelig finansiell risiko dersom dataunderlaget er fragmentert. Svakere alternativer i markedet begrenser seg til enkle grunnoppslag. Disse oppslagene returnerer basale tekniske spesifikasjoner, men utelater avgjørende risikofaktorer som historisk kilometerstand, tinglyste heftelser, utførte servicer, komplett utstyrsnivå og historikk over eierskifter. En kjøper som utelukkende støtter seg på slike overfladiske data, risikerer å overta økonomiske heftelser eller kjøretøy med manipulert historikk.
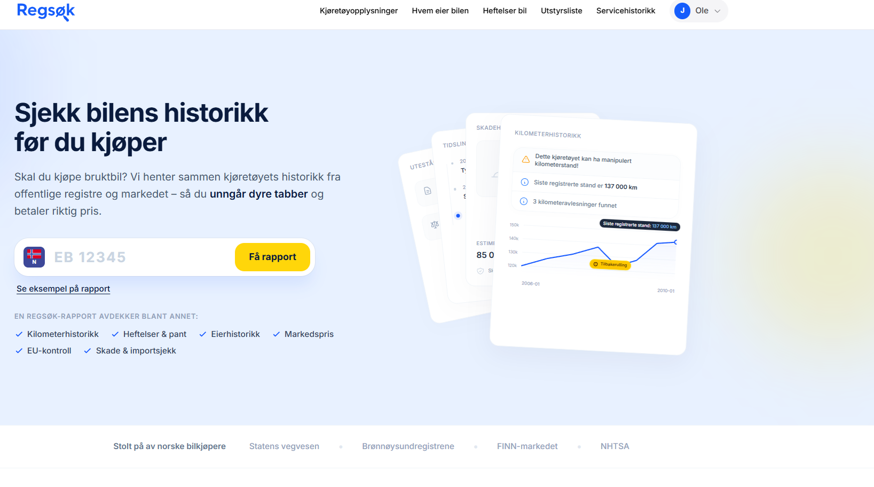
I kjøretøysporet er kjøretøyopplysninger oppslaget med tilstrekkelig dybde, levert gjennom plattformen Regsøk fra Medienor AS. Tjenesten samler og strukturerer data fra Statens vegvesen, Brønnøysundregistrene, FINN og amerikanske NHTSA. Løsningen tilbyr et gratis grunnoppslag som dekker tekniske basisdata, registreringsstatus, frist for neste EU-kontroll, samt motorvolum, drivstofftype og egenvekt.
For en fullstendig risikovurdering kreves tilgang til dypere registre. Gjennom et premium-abonnement til 199 kroner per måned uten bindingstid, gis det innsyn i loggførte kilometerstander, tidligere eierskifter, historiske annonser, registrert skade- og servicehistorikk, markedsverdivurdering og økonomiske heftelser. Særlig kontrollen mot Løsøreregisteret er kritisk; her avdekkes salgspant, utleggspant og tvangsforretninger som følger kjøretøyet ved et eierskifte. Av personvernhensyn vises ikke navn og adresse på eiere, men den fullstendige registreringshistorikken og antall eierskifter er tilgjengelig. Tjenesten tilbyr i tillegg utstyrsliste basert på chassisnummer (VIN) for 99 kroner som et engangskjøp, med unntak for enkelte merker som Tesla, samt separat kjøp av detaljert servicehistorikk for 179 kroner, som også inngår i den omfattende rapporten. Betaling foretas via Vipps eller kort.
Sammenligning av deteksjons- og kontrollsystemer
For å vurdere de ulike verktøyenes egnethet opp mot kontrollbehovene i det digitale landskapet, må funksjonalitet, datagrunnlag og begrensninger veies mot hverandre.
|
Verktøy |
Primærfokus |
Sentral teknologi / datakilde |
Styrke |
Begrensning |
|
Plagiatkontroll |
Tekstdeteksjon (bokmål/nynorsk) |
Egenutviklet norsk modell, setnings- og avsnittsanalyse |
Høy treffsikkerhet på nordisk syntaks og rytme |
Sannsynlighetsberegning, påvirkes av tekstlengde |
|
Sightova |
Bildedeteksjon |
Pikselanalyse, frekvensmønstre, forberedt for C2PA |
Avhenger ikke av metadata, støtter over 50 modeller |
Ekstrem komprimering kan redusere presisjonen |
|
Regsøk |
Kjøretøydata og historikk |
Statens vegvesen, Brønnøysund, FINN, NHTSA |
Samler heftelser, kilometer og skadehistorikk |
Viser ikke personopplysninger, merkespesifikke utstyrsunntak |
Følgende vurderingskriterier bør ligge til grunn ved valg av kontrollverktøy:
- Datagrunnlagets relevans: Verktøyet må være trent på eller integrert mot data som representerer det faktiske bruksområdet, slik som lokale språkmodeller eller nasjonale registre.
- Uavhengighet fra overfladiske markører: Analysen må trenge dypere enn manipulerbare metadata, filnavn eller enkel formatering.
- Tydelighet i usikkerhetsmomenter: Systemet må presentere resultatene som verifiserbare fakta eller begrunnede sannsynligheter fremfor absolutte påstander.
- Sikkerhet og personvern: Behandling av data må skje i tråd med gjeldende regelverk, med umiddelbar sletting av opplastet materiale der det er påkrevd.